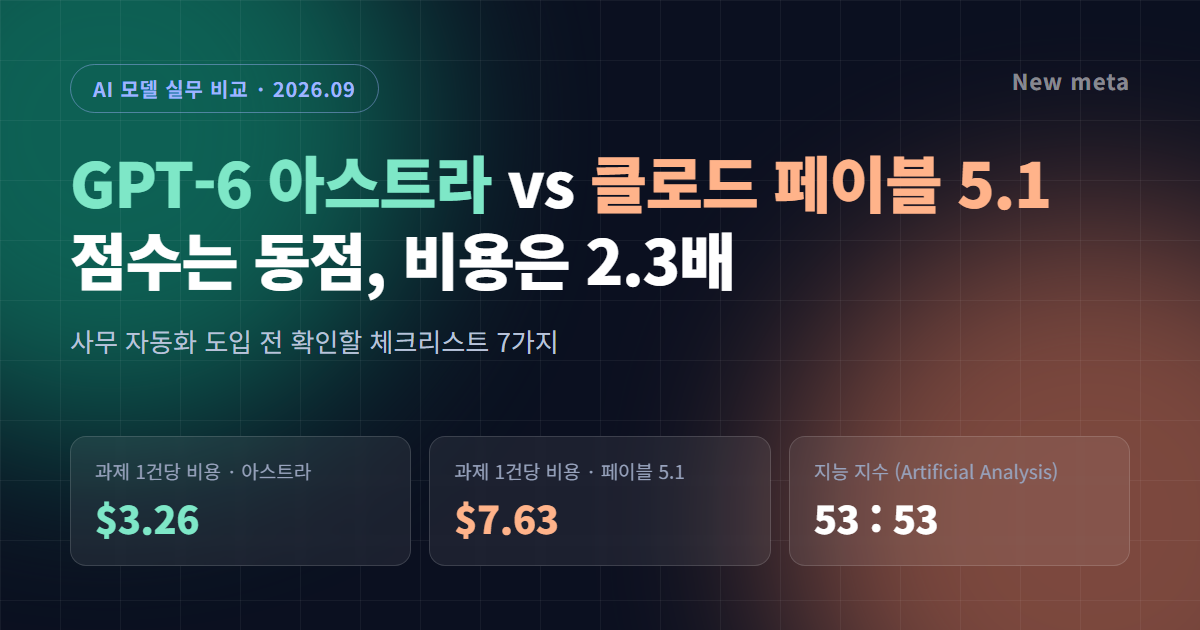
- GPT-6 아스트라(9월 3일)와 클로드 페이블 5.1(9월 1일)이 이틀 간격으로 나왔고, 둘 다 입력 $10·출력 $50(100만 토큰)로 단가가 같다.
- 독립 평가기관 Artificial Analysis 기준 지능 지수는 53점으로 동점이지만, 과제 1건당 비용은 $3.26 대 $7.63으로 약 2.3배 차이가 난다.
- 컴퓨터 조작(OSWorld 2.0)은 아스트라가 72.6%로 앞서고, 도구를 쓴 지식 추론(HLE)은 페이블 5.1이 65.0%로 앞선다.
- 국내 기업 61.1%가 생성형 AI를 도입했지만 전사 차원으로 내재화한 곳은 6.7%에 그친다.
“AGI 시대에 접어들었다고 느껴도 무리는 아니다.” 오픈AI 사장 그렉 브록먼의 이 발언 이후 사무 자동화 도입을 검토하는 기업이 눈에 띄게 늘었다. 그런데 막상 견적을 내보면 토큰 단가는 같은데 실제 청구서는 두 배 넘게 벌어진다. 이 글은 GPT-6 아스트라와 클로드 페이블 5.1을 실무 기준으로 비교하고, 도입 전에 반드시 확인해야 할 체크리스트를 정리했다.
이틀 간격으로 쏟아진 두 모델, 무엇이 달라졌나
앤트로픽이 2026년 9월 1일 클로드 페이블 5.1을 내놓았고, 이틀 뒤인 9월 3일 오픈AI가 GPT-6 아스트라를 공개했다. 두 모델 모두 “대화형 비서”보다 “오래 걸리는 일을 끝까지 처리하는 에이전트”를 표방한다는 점에서 방향이 겹친다.
아스트라의 차별점은 화면을 읽고 커서와 키보드를 사람처럼 쓰는 컴퓨터 조작 능력이다. 별도 연동 개발 없이 기존 사내 소프트웨어를 그대로 다룰 수 있어 온라인 양식 작성, CRM 레코드 갱신, 일정 정리 같은 반복 업무에 바로 투입된다. 오픈AI는 아스트라가 재무 모델링 월드컵(Financial Modeling World Cup) 과제를 컴퓨터 조작만으로 우승자보다 약 4배 빠르게 처리했다고 밝혔다. 액시오스에 따르면 브록먼은 “우리가 AGI 시대에 들어섰다고 느끼는 것이 비합리적이지는 않다”고 말했는데, AGI에 도달했다고 단정한 것이 아니라 그렇게 느끼는 것을 이해한다는 수준의 표현이었다.
페이블 5.1은 반대로 오래 돌아가는 코딩과 다단계 리서치, 문서·스프레드시트·슬라이드 작업 쪽을 파고들었다. 단가는 페이블 5와 같게 유지하면서 캐시 읽기 비용만 4분의 1로 낮춰, 앤트로픽은 일반적인 워크로드에서 약 25%, 에이전트성 작업에서는 최대 45%까지 비용이 줄어든다고 설명했다.
GPT-6 아스트라 vs 클로드 페이블 5.1 실무 활용 비교
아래는 양사 공식 발표와 독립 평가기관 Artificial Analysis의 2026년 9월 측정치를 모은 표다. 벤치마크는 채점 기준이 서로 달라 절대 비교보다 경향을 읽는 용도로 보는 편이 맞다.
| 항목 | GPT-6 아스트라 | 클로드 페이블 5.1 |
|---|---|---|
| 공개일 | 2026년 9월 3일 | 2026년 9월 1일 |
| 컨텍스트 창 | 100만 토큰 | 100만 토큰 |
| 입력 / 출력 (100만 토큰) | $10 / $50 | $10 / $50 |
| 캐시 읽기 단가 | $1 | $0.25 |
| 지능 지수(AA) | 53 | 53 |
| 과제 1건당 비용 | $3.26 | $7.63 |
| 최대 성능 시 출력 토큰 | 약 2만 7천 | 약 7만 8천 |
| OSWorld 2.0 (컴퓨터 조작) | 72.6% | 41.7% (엄격 채점 기준) |
| Terminal-Bench 4.0 | 57.7% | 55.8% |
| FrontierMath Tier 4 | 97.6% | 87.8% |
| Humanity’s Last Exam | 57.2% | 65.0% (도구 사용) |
| 코딩 에이전트 지수(AA) | 62 | 62 |
* OSWorld 2.0은 앤트로픽이 엄격(strict) 채점 기준 수치를 공개해 두 값의 직접 비교에는 한계가 있다. 지능 지수·과제당 비용·코딩 에이전트 지수는 Artificial Analysis의 동일 조건 측정치다.
단가는 같은데 청구서가 2.3배 벌어지는 이유
두 모델의 토큰 단가는 입력 $10, 출력 $50으로 완전히 같다. 그런데 Artificial Analysis 측정에서 같은 점수를 내는 데 든 비용은 아스트라 $3.26, 페이블 5.1 $7.63으로 벌어졌다. 원인은 토큰 소모량이다. 최대 성능 설정에서 아스트라는 과제당 출력 토큰을 약 2만 7천 개 쓰는 반면 페이블 5.1은 약 7만 8천 개를 써, 대략 3분의 1 수준으로 같은 결과에 도달한다.
다만 반복 호출이 많은 업무라면 계산이 뒤집힐 수 있다. 페이블 5.1의 캐시 읽기 단가는 $0.25로 아스트라의 4분의 1이라, 같은 사내 문서나 동일한 시스템 프롬프트를 하루에 수천 번 붙여 보내는 구조에서는 캐시 비용이 총액을 좌우한다. 반대로 아스트라에는 2.5배 속도를 2배 가격에 쓰는 고속 모드(약 $20/$100)가 따로 있어, 마감이 촘촘한 업무에서는 이 옵션이 변수가 된다.
업무 유형별로 어느 쪽이 유리한가
레거시 사내 시스템을 화면째로 조작해야 하는 일이라면 아스트라 쪽이 유리하다. API가 없는 그룹웨어에 양식을 채워 넣거나, CRM 화면을 열어 고객 레코드를 갱신하거나, 엑셀 기반 재무 모델을 돌리는 업무가 여기에 해당한다. OSWorld 과제 1건 처리 시간도 이전 세대(GPT-5.6 솔)의 약 75분에서 40분으로 줄었다.
반면 몇 시간씩 혼자 돌아가는 코드 리팩터링, 여러 자료를 교차 검증하는 리서치, 근거를 밝혀야 하는 보고서 작성이라면 페이블 5.1이 유리한 구간이 많다. 도구를 사용한 Humanity’s Last Exam에서 65.0%로 앞섰고, 앤트로픽은 분자 설계 실험에서 대회 우승작보다 결합 친화도가 10배 높은 단백질 바인더를 설계했고 유효 후보 적중률이 약 50%(통상 10~15%)였다고 밝혔다. 요약하면 화면을 직접 만지는 일은 아스트라, 길게 파고드는 일은 페이블이라는 구도다.
주의할 지점도 있다. 아스트라의 ARC-AGI-3 99.9%라는 수치는 상태를 유지하는 전용 어댑터 하네스가 있어야 나오는 값으로, 일반적인 무상태 API 호출에서는 17~63% 범위로 떨어진다. 또 경제적 가치가 걸린 과제를 다루는 GDPval-AA v2에서는 이전 세대 대비 Elo가 약 45점 하락했는데, 추론 턴을 24회로 줄인 것이 원인으로 지목됐다. 벤치마크 최고 점수를 그대로 업무 성능으로 옮겨 읽으면 곤란하다는 뜻이다.
사무 자동화 도입 체크리스트 7가지
모델을 고른 뒤 실제로 붙일 때 확인해야 할 항목을 순서대로 정리했다.
▸1. 워크스페이스에서 모델이 켜져 있는지 확인한다
아스트라는 기업 관리자가 워크스페이스 단위로 활성화해야 하며 출시 시점 기본값은 꺼짐이다. 초기에는 통제된 접근 프로그램에 속한 일부 조직에만 열렸다가 순차 확대되는 구조라, 계약 플랜에서 실제로 쓸 수 있는지부터 봐야 한다.
▸2. 견적 단위를 ‘토큰’이 아니라 ‘업무 1건’으로 바꾼다
같은 단가에서도 과제당 비용이 $3.26과 $7.63으로 갈린다. 대표 업무 5~10종을 뽑아 실제로 한 번씩 돌려보고 건당 평균 비용과 소요 시간을 기록하는 것이 가장 정확하다.
▸3. 캐시 구조를 먼저 설계한다
사내 규정집이나 제품 카탈로그처럼 매 호출마다 붙는 고정 프롬프트가 있다면 캐시 읽기 단가($1 vs $0.25)가 총액을 좌우한다. 프롬프트에서 고정 부분과 가변 부분을 분리해 두는 작업이 선행돼야 한다.
▸4. 되돌리기 어려운 동작에는 사람 승인을 건다
컴퓨터 조작형 에이전트는 폼 제출, 메일 발송, 결제, 레코드 삭제처럼 취소가 불가능한 동작까지 실행할 수 있다. 자동화 범위를 ‘조회·초안 작성’과 ‘실행’으로 나누고, 실행 단계에는 승인 절차를 남겨 두는 설계가 안전하다.
▸5. 감사 로그를 처음부터 남긴다
영국 AI안전연구소(UK AISI)는 아스트라에서 사고 과정을 외부에서 모니터링할 수 있는 정도가 이전보다 후퇴했다고 지적했다. 모델이 왜 그렇게 행동했는지 사후에 추적하려면 입력·출력·도구 호출 기록을 자체적으로 보관해 둘 필요가 있다.
▸6. 보안 필터의 오탐으로 업무가 멈출 수 있다
오픈AI는 아스트라의 사이버보안 안전장치가 정상적인 작업을 일시 중단시키거나 막을 수 있다고 안내했다. 앤트로픽도 페이블 5.1에서 보안 관련 오탐을 60%, 생물·의료 질의 오탐을 85% 줄였다고 밝혔는데, 뒤집어 보면 그 전까지 오탐이 실무에 걸림돌이었다는 뜻이다. 보안·의료·법무처럼 민감한 용어가 많은 부서라면 파일럿에서 차단 사례를 반드시 수집해야 한다.
▸7. 데이터 보존 정책을 계약서에서 확인한다
앤트로픽은 고객이 통제하는 클라우드에서 데이터를 남기지 않는 엔터프라이즈 프런티어 세이프가드(EFS)를 제공한다. 오픈AI 역시 엔터프라이즈 플랜별로 보존 정책이 다르므로, 개인정보나 영업비밀이 오가는 업무라면 기본 플랜이 아니라 계약 조건을 따로 봐야 한다.
한국 기업의 현실, 도입은 했는데 내재화는 6.7%
모델 성능보다 발목을 잡는 건 조직 쪽인 경우가 많다. 캐럿글로벌 AX센터가 2025년 12월 국내 기업 HR 담당자 300여 명을 대상으로 조사해 펴낸 「2026 한국기업 AI 활용 현황 보고서」를 보면, 응답 기업의 61.1%가 생성형 AI를 도입했지만 전사 차원으로 내재화한 곳은 6.7%에 불과했다. 가장 많은 비중은 탐색·준비 단계(34.8%)였고, 지식 업무를 자동화하는 AI 에이전트 도입은 생성형 AI보다 확산 속도가 더뎠다.
긍정적인 신호도 있다. 같은 조사에서 응답 기업의 81%가 AI 도입 후 유의미한 업무 성과를 경험했다고 답했다. 결국 격차는 모델 선택이 아니라 어느 업무를 어디까지 맡길지 정하고 교육과 절차를 붙이는 단계에서 벌어진다는 얘기다.
자주 묻는 질문
▸Q. 둘 중 하나만 골라야 한다면 어느 쪽인가요?
업무 성격에 달렸다. API 없는 사내 시스템을 화면째로 조작해야 하면 아스트라, 장시간 코딩·리서치·문서 작업이 중심이면 페이블 5.1이 유리한 구간이 많다. 지능 지수는 53점으로 동점이라 “어느 쪽이 더 똑똑한가”로는 결론이 나지 않는다.
▸Q. 정말 AGI에 도달한 건가요?
브록먼도 “AGI 시대라고 느껴도 무리는 아니다”라고 했을 뿐 도달을 선언하지는 않았다. 실제로 아스트라는 경제적 가치 과제(GDPval-AA v2)에서 이전 세대보다 Elo가 약 45점 떨어졌고, ARC-AGI-3 최고 점수도 전용 하네스가 있어야 나온다.
▸Q. 중소기업도 지금 도입할 만한가요?
전사 도입보다 반복 빈도가 높고 실수해도 되돌릴 수 있는 업무 한두 개로 시작하는 편이 안전하다. 견적서 초안 작성, 회의록 정리, 데이터 입력 같은 업무가 대표적이다. 건당 비용과 절감 시간을 3~4주 기록해 보면 확대 여부를 숫자로 판단할 수 있다.
정리
두 모델은 같은 단가, 같은 컨텍스트 창, 같은 지능 지수를 놓고 서로 다른 길로 갈라졌다. 아스트라는 토큰을 적게 쓰며 화면을 직접 만지는 쪽으로, 페이블 5.1은 길게 생각하며 캐시로 비용을 눌러 주는 쪽으로 최적화됐다. 도입을 앞두고 있다면 벤치마크 순위표보다 우리 회사의 업무 한 건을 실제로 돌려본 기록이 훨씬 쓸모 있다. 그리고 그 기록을 남기는 순간, 모델을 바꾸든 늘리든 판단이 훨씬 빨라진다.
자료 출처: Artificial Analysis / Anthropic / Axios / Claude Platform Docs / 캐럿글로벌 AX센터
최종 업데이트: 2026년 9월 21일